※本ページにはプロモーション(広告)が含まれています。
【2026年11月】Whisperで音声を自動でテキスト化する方法|自分のサーバーで動かす文字起こしの仕組みと必要スペック
実測・公式情報にもとづいて執筆しています
会議の録音を聞き直しながら議事録を打ち込む作業や、動画の字幕づくりに何時間も取られていませんか。外注すればお金がかかり、自分でやれば時間が消えていく。文字起こしは、地味なのに手間の大きい仕事です。
そこで注目されているのが、OpenAIが公開している音声認識モデル「Whisper(ウィスパー)」です。日本語にも対応していて、音声ファイルを渡すだけで文章に起こしてくれます。しかもモデルそのものが公開されているので、自分のパソコンやVPS(ネット上に借りる自分専用のサーバー)で動かすこともできます。
本記事では、Whisperで文字起こしをする方法を「APIを使う」「自分のサーバーで動かす」の2つに分けて整理し、必要なスペックの目安、VPSで自動化する流れまで、初めての方向けに順番に解説します。手順の部分は公式ドキュメントの流れを要約して紹介する形にしています。
本記事は2026年11月時点の公式情報をもとに執筆しています。
結論:まずは軽い実行ソフトと小さめのモデルで試すのが近道
最初に結論をまとめます。
- Whisperは「音声→文字」専用のAIモデルです。モデル自体は無料で公開されていて、自分のサーバーで動かせます
- 使い方は2通りです。OpenAIのAPIに音声を送る方法と、自分のパソコンやVPSでモデルを動かす方法があります
- 自分で動かすなら、軽量な実行ソフトを選ぶのがコツです。whisper.cppやfaster-whisperを使うと、GPU(画像処理用の高速な計算装置)が無い普通のVPSでも動かせます
- メモリの目安は4GB前後からです。小さめのモデルなら2GBでも動きますが、日本語の精度を求めて大きめのモデルを使うなら4GB〜8GBを見ておくと安心です
「毎週の会議録音を自動で文字にしたい」「録音データを外部のサービスに送りたくない」という方は、自分のサーバーで動かす方法がぴったりです。
Whisperとは?OpenAIが公開している音声認識モデル
Whisperは、OpenAIが開発して公開した音声認識(音声を聞き取って文字にする技術)のモデルです。公式のGitHubでは、ソースコードとモデルがMITライセンス(商用利用も含めて自由に使える、制限のゆるいライセンス)で公開されています。
モデルは6つのサイズから選べる
公式のREADMEでは、Whisperのモデルは6つのサイズが用意されており、サイズによって速さと精度のバランスが変わると説明されています。
| モデル | パラメータ数 | 必要なGPUメモリの目安 | 速さ(largeとの比較) |
|---|---|---|---|
| tiny | 3,900万 | 約1GB | 約10倍 |
| base | 7,400万 | 約1GB | 約7倍 |
| small | 2億4,400万 | 約2GB | 約4倍 |
| medium | 7億6,900万 | 約5GB | 約2倍 |
| large | 15億5,000万 | 約10GB | 1倍 |
| turbo | 8億900万 | 約6GB | 約8倍 |
パラメータ数は、ざっくり言うと「モデルの頭脳の大きさ」です。大きいほど聞き取りの精度は上がりやすい反面、動かすのに必要なメモリと時間が増えます。turboは、largeの最新版(large-v3)を速く動くように改良したモデルで、精度の低下は小さいと案内されています。
なお、この表のメモリはGPUで動かす場合の目安です。GPUの無いVPSで動かす場合の目安は、後ほど別の表で紹介します。
日本語の精度は「言語と音質しだい」
公式のREADMEでは、Whisperの性能は言語によって大きく差があると説明されています。日本語にも対応していますが、マイクから遠い声、複数人が同時に話す場面、雑音の多い録音では誤りが増えます。どのモデルでも、出てきた文章を人がざっと見直す前提で使うのが現実的です。
文字起こしの方法は2つ:APIか、自分のサーバーか
Whisperで文字起こしをする方法は、大きく分けて2つあります。
| 方法 | 仕組み | 向いている人 |
|---|---|---|
| OpenAIのAPI | 音声ファイルをOpenAIのサーバーに送り、文字にして返してもらう | 手軽に始めたい人、文字起こしの量が少ない人 |
| 自分のサーバーで動かす | 公開されているモデルを自分のパソコンやVPSで動かす | 量が多い人、録音を外部に送りたくない人、自動化したい人 |
APIを使う場合の料金と注意点
OpenAIの料金ページ(2026年11月時点)では、文字起こし用のモデルとして「gpt-transcribe」が1分あたり0.0045ドルの目安と表示されています。たとえば1時間の会議なら約0.27ドルで、1ドル150円で計算すると約41円です。月に20時間分を文字起こしすると約5.4ドル(約810円)になります。
注意しておきたいのは次の2点です。
- 1ファイル25MBまで:公式の音声認識ガイドでは、APIに送れるファイルは25MBまでとされています。長い録音は、圧縮した形式に変えるか、25MB以下に分割して送るよう案内されています
- 旧モデルは提供終了が予定されている:同じガイドでは、APIの「whisper-1」などのモデルは2027年2月26日に提供を終了すると告知されています。これから作る仕組みは、案内されている新しいモデルを使う前提で組みましょう
APIの提供終了は、OpenAIのサーバー上で動くモデルの話です。GitHubで公開されているWhisperのモデルを自分のサーバーで動かす方法は、この告知の対象として書かれていません。
自分のサーバーで動かすメリット
自分のサーバーで動かす場合、かかるお金はサーバー代だけです。何時間ぶん文字起こしをしても、1分ごとの料金はかかりません。また、録音データが自分のサーバーの外に出ないので、社外秘の会議や個人的な録音を扱いたい方にも向いています。
反対に、文字起こしの量が月に数時間程度なら、APIのほうが安く手軽に済むこともあります。まずは自分がどれくらいの量を文字にしたいかを考えてから選ぶと、無駄がありません。
自分で動かすなら、3つの実行ソフトから選ぶ
Whisperのモデルを動かすソフトは、OpenAIの本家版のほかに、軽く速く動くように作り直された版があります。代表的な3つを比べてみましょう。
| ソフト | 特徴 | 向いている使い方 |
|---|---|---|
| openai-whisper(本家) | OpenAI公式。Pythonで動き、ffmpeg(音声・動画の変換ソフト)が別途必要 | GPUのあるパソコンで試す |
| faster-whisper | 本家と同じ精度で最大4倍速く、メモリも少なく済むと案内されている。Pythonで動き、ffmpegの別途インストールは不要 | Pythonで自動化の仕組みを作る |
| whisper.cpp | C/C++で書かれた軽量版。GPUなしのCPUだけでも動かせる | GPUの無い普通のVPSで動かす |
CPUだけで動かしたときの比較(公式のベンチマーク)
faster-whisperの公式READMEには、13分の英語音声をsmallモデルで文字起こししたときの比較が載っています。Intel Core i7-12700K(8スレッド)での結果は次のとおりです。
| ソフト | かかった時間 | 使ったメモリ |
|---|---|---|
| openai-whisper(本家) | 6分58秒 | 約2.3GB |
| whisper.cpp | 2分05秒 | 約1.0GB |
| faster-whisper | 2分37秒 | 約2.3GB |
| faster-whisper(8bit化) | 1分42秒 | 約1.5GB |
8bit化(量子化)とは、モデルの数値を軽い形に圧縮して、少ないメモリで速く動かす工夫です。本家版に比べて、軽量版はかかる時間がおよそ3分の1から4分の1になっていることがわかります。
ただし、これはデスクトップ用の高性能なCPUでの結果です。VPSのCPUはプランによって性能やコア数(同時に作業できる数)が違うので、同じ速さが出るとは限りません。それでも「本家より軽量版のほうがずっと速い」という傾向は、VPS選びの参考になります。
必要なスペックの目安:GPUなしならメモリで選ぶ
GPUの無い普通のVPSで動かす場合は、メモリの大きさが一番の判断材料になります。whisper.cppの公式READMEには、モデルごとのファイルサイズと使うメモリの目安が載っています。
| モデル | ファイルサイズ | 使うメモリの目安 |
|---|---|---|
| tiny | 75MiB | 約273MB |
| base | 142MiB | 約388MB |
| small | 466MiB | 約852MB |
| medium | 1.5GiB | 約2.1GB |
| large | 2.9GiB | 約3.9GB |
この数字はWhisperが使う分だけなので、OSや自動化のスクリプトが使う分を上乗せして考えます。公式の数字をもとにした目安(公式の要件ではありません)は次のとおりです。
- small以下でまず試す:2GBプランでも動かせます
- 日本語の精度を上げたくてmediumを使う:4GBプランが目安です
- large系を使う:使うメモリだけで約3.9GBあるので、8GBプランを選ぶと余裕があります
日本語の会議録音なら、まずはsmallかmediumで試し、誤りが多いと感じたら大きいモデルに切り替えていく順番がおすすめです。プランは後から上げられるVPSが多いので、最初から大きなプランを契約する必要はありません。
VPSで文字起こしを動かす流れ(公式ドキュメントの要約)
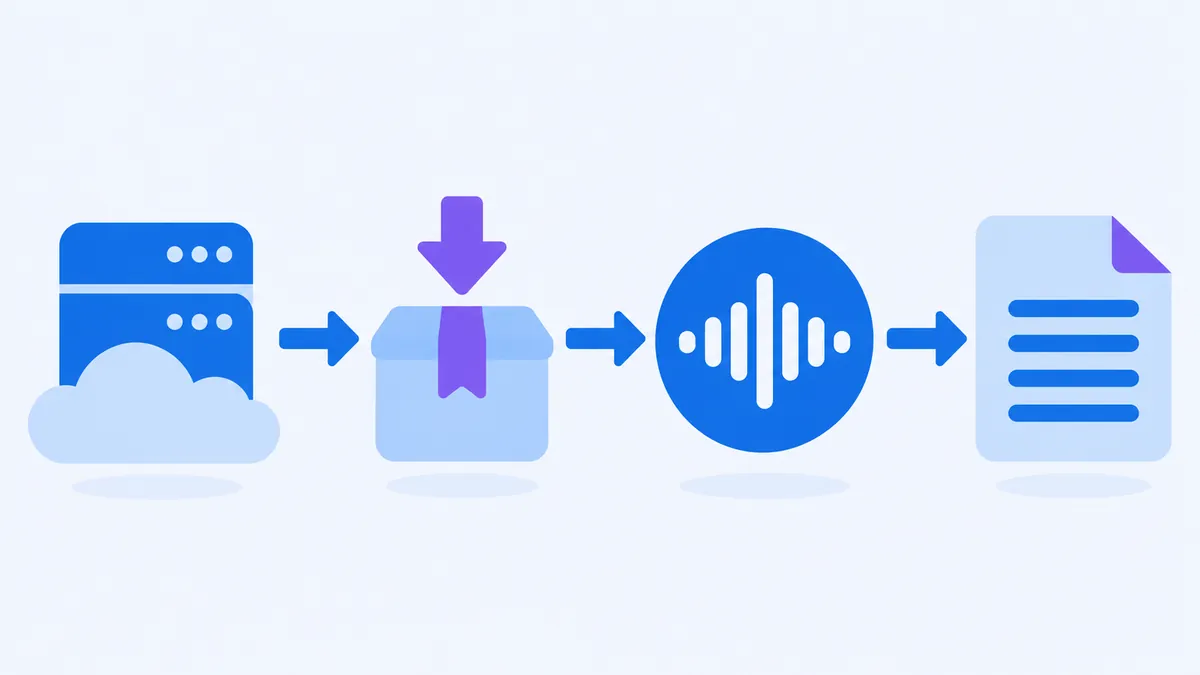
ここでは、GPUの無いVPSで使いやすいwhisper.cppを例に、公式READMEで案内されている流れを要約して紹介します。細かいオプションや最新のコマンドは、必ずwhisper.cppの公式GitHubで確認してください。
1. VPSを用意して、whisper.cppを入れる
公式のクイックスタートでは、GitHubからwhisper.cppをダウンロード(クローン)し、cmake というビルド用のツールで実行ファイルを作る流れになっています。Ubuntuなど一般的なLinuxのVPSなら、ビルドに必要な道具を入れてからコマンドを数行打つだけで準備できます。
2. モデルをダウンロードする
付属のスクリプトで、使いたいサイズのモデルをダウンロードします。最初は軽いモデルで動作を確かめ、慣れてきたらmediumやlargeに切り替えるとつまずきにくいです。
3. 音声ファイルを文字にする
公式によると、whisper.cppの whisper-cli は16bitのWAV形式のファイルを読み込みます。スマホの録音(m4aやmp3など)を使う場合は、ffmpegで次のように変換してから渡すよう案内されています。
ffmpeg -i input.mp3 -ar 16000 -ac 1 -c:a pcm_s16le output.wav
変換したファイルを whisper-cli に渡すと、文字起こしの結果が出てきます。日本語の音声は、言語を日本語に指定して実行します。
Pythonで組み込みたい場合
自動化の仕組みをPythonで作りたい方は、faster-whisperを使う方法もあります。公式では pip install faster-whisper でインストールでき、Python 3.9以上が必要とされています。本家版と違ってffmpegを別に入れなくてよいのも、初心者にはうれしいポイントです。
本家のopenai-whisperを使う場合は、whisper 音声ファイル --language Japanese のように言語を指定して実行する例が公式に載っています。
自動化のアイデア:録音を置くだけで文字になる仕組み
VPSで動かす一番の利点は、パソコンを閉じていても文字起こしが進むことです。たとえば次のような仕組みが作れます。
- フォルダに置いたら自動で文字起こし:決まったフォルダを定期的に見に行き、新しい録音があれば文字にしてテキストを保存するスクリプトを、cron(決まった時刻に処理を動かすLinuxの機能)で動かします
- ノーコードツールとつなぐ:n8nのような自動化ツールと組み合わせると、「録音が届いたら文字起こしして、チャットに送る」といった流れを画面上で組み立てられます
- APIとして呼び出す:whisper.cppには、HTTP経由で文字起こしを頼める
whisper-serverという例が同梱されており、公式ではOpenAIのAPIに似た形式と説明されています。他のアプリから文字起こしを呼び出したいときに便利です
Pythonのスクリプトを24時間動かす基本はPythonスクリプトをVPSで常時稼働させる方法で、n8nの導入はn8nをVPSでセルフホストする方法で解説しています。他のサービスから合図を受けて処理を動かす仕組みはWebhookとは?が参考になります。
Whisperを動かすVPSの選び方と料金
Whisperを動かすVPSは、使いたいモデルの大きさに合わせてメモリで選ぶのが基本です。CPUのコア数が多いほど処理は速くなりやすいので、同じメモリならコア数も見比べておきましょう。ここでは、すぐに申し込めて、Linuxで始めやすい2社の料金を紹介します(2026年11月時点の公式料金ページの表示額)。
| メモリ | シンVPS(コア数) | シンVPS(1ヶ月契約) | シンVPS(36ヶ月契約) | さくらのVPS(コア数) | さくらのVPS(石狩・月払い) | さくらのVPS(石狩・年払いの月額換算) |
|---|---|---|---|---|---|---|
| 2GB | 2コア | 1,040円/月 | 950円/月 | 3コア | 1,738円/月 | 1,594円/月 |
| 4GB | 3コア | 1,800円/月 | 1,350円/月 | 4コア | 3,520円/月 | 3,227円/月 |
| 8GB | 4コア | 3,450円/月 | 2,620円/月 | 6コア | 7,040円/月 | 6,454円/月 |
- シンVPSは大容量メモリプランの料金で、初回と更新時が同じ額です。最低利用期間は3ヶ月です
- さくらのVPSは税込表示で、申し込み時にクレジットカード払いを選ぶと全プラン2週間無料で試せます。お試し期間のうちに、自分の録音でどのくらいの速さと精度が出るかを確かめておくと、プラン選びで失敗しません
APIで月に20時間ぶん文字起こしすると約810円なので、それ以上の量を文字にしたい方や、録音を外部に送りたくない方は、VPSで動かすほうが割安かつ安心になりやすいです。
なお、筆者が普段使っているConoHa VPSは、2026年11月3日時点で公式サイトに臨時メンテナンスのため新規申し込みを停止していると表示されており、再開時期は公表されていません。今すぐ始めたい方は、上の2社から選ぶのが確実です。
VPSの選び方そのものに迷っている方は、ConoHa VPS・シンVPS・さくらのVPSの比較や、VPSは初心者には難しい?もあわせて読んでみてください。


よくある質問
Q. Whisperは無料で使えますか?
モデルとソフトは無料で公開されているので、自分のパソコンやVPSで動かす分にはソフトの料金はかかりません。かかるのはVPSの料金だけです。OpenAIのAPIで文字起こしする場合は、1分ごとの利用料がかかります。
Q. 日本語の文字起こしの精度はどのくらいですか?
公式では、精度は言語によって大きく差があると説明されています。日本語でも、はっきり話した録音ならかなり読める文章になりますが、雑音や話者の重なりが多いと誤りが増えます。固有名詞や専門用語も間違えやすいので、最後に人が見直す前提で使いましょう。
Q. GPUが無いと遅すぎて使えませんか?
whisper.cppやfaster-whisperのような軽量版を使えば、GPUなしでも実用的に動かせます。faster-whisperの公式ベンチマークでは、13分の音声をsmallモデルで約2分前後で文字にできています(高性能なデスクトップCPUでの結果)。VPSでは時間がかかる場合もありますが、夜のうちに自動で処理しておく使い方なら速さはあまり気になりません。
Q. 誰が話したか(話者)も分けてくれますか?
Whisper本体は「音声を文字にする」モデルで、話者を分ける機能は基本的にありません。whisper.cppには話者の切り替わりを見分ける実験的な機能もありますが、公式の使用例は英語用のモデルです。日本語の会議で使うなら、話者の区別は人が補うか、別のツールと組み合わせる前提で考えるのが無難です。
Q. プログラミングの知識がなくても使えますか?
コマンドをコピーして貼り付けられれば、1つのファイルを文字にするところまではたどり着けます。「フォルダに置いたら自動で文字起こし」のような自動化まで作るなら、Pythonの簡単なスクリプトか、n8nのようなノーコードツールを使うと進めやすくなります。
Q. 録音データをサーバーに置いて大丈夫ですか?
自分のサーバーで動かす場合、録音は自分が借りているVPSの中で処理され、外部のAIサービスには送られません。ただし、VPSそのものの守り(パスワードを強くする、使わない入口を閉じる、OSを更新する)は自分の責任です。社外秘の録音を扱うなら、最初にこの基本を済ませておきましょう。
まとめ
Whisperでの文字起こしについて、ポイントをまとめます。
- Whisperは、OpenAIが無料で公開している音声認識モデル。APIでも、自分のサーバーでも使える
- APIは手軽だが1分ごとに料金がかかり、旧モデルは2027年2月26日に提供終了予定。量が多いなら自分のサーバーで動かすほうが割安になりやすい
- GPUの無いVPSなら、whisper.cppやfaster-whisperのような軽量版を選ぶ
- メモリはsmallで2GB、mediumで4GB、large系なら8GBが目安
会議の録音を置いておくだけで翌朝には文字になっている。そんな仕組みが自分の手で作れると、議事録や字幕づくりにかけていた時間を、本当に考えるべき仕事に回せるようになります。まずは小さめのプランとsmallモデルで、自分の録音を1本文字にしてみるところから始めてみてください。